§ 08 / program · uzun konuşma
RLAIF ile Model Finetuning/PreTraining'in de Insan Kaynaklı Darboğazının Kaldırılması
§ 01 / özet
Konuşma hakkında.
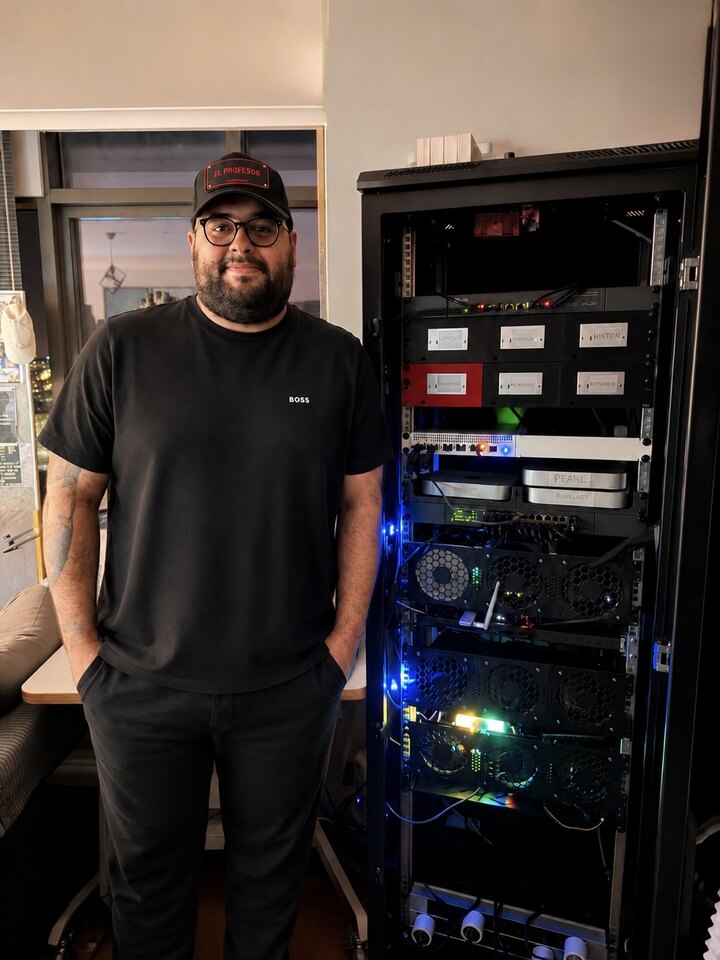
Yapay Zeka Geri Bildirimiyle Pekiştirmeli Öğrenme (RLAIF) ile modelleri artık insan datasına en az ihtiyaç ile Instruct ve SFT temelli pekiştirmeli öğrenme döngüleri oluşturabiliyoruz. Bu da modellerin insan feedback'lerine ihtiyaç duymadan öğretmen/öğrenci yapısında insansız eğitim süreci sağlatıyor. Kendi Homelab'imde oluşturduğum yapı ile Finans, Legal ve Siber Güvenlik alanlarında geliştirdiğim Türkçe temelli açık kaynak LLM ve VLM modellerimi bu sayede 7/24 minimum insan etkileşimli geliştirebiliyorum.
§ 02 / konuşmacı
Sahnede.
§ 03 / akıştaki yeri
Günün neresinde.
-
Büyük Ölçekte Bir GPU Filosunun Kendini Onarması
Daglar Berk Erdem · FAL.ai
kısa konuşma · 20 dk Türk İşaret Dili çevirisiTR Türk İşaret Dili çevirisi - Ara 20 dk
-
RLAIF ile Model Finetuning/PreTraining'in de Insan Kaynaklı Darboğazının Kaldırılmasıbu konuşma
Alican Kiraz · Trendyol
uzun konuşma · 40 dk Türk İşaret Dili çevirisiTR Türk İşaret Dili çevirisi -
Karanlıkta Kalan Kodu Çalıştırın: Agent'ınızın Hata Yönetimi Neden Hiç Çalışmadı ve Onu Nasıl Bilinçli Olarak Çalıştırabilirsiniz?
Cenk Kalpakoglu · Invicti
kısa konuşma · 20 dkEN -
Kritik Sistemlerde AI Modeli Geliştirmek ve Çalıştırmak: Açıklanabilir, Denetlenebilir ve Güvenilir Modeller Nasıl Tasarlanır?
Fatih Bildirici · ASELSAN
kısa konuşma · 20 dk Türk İşaret Dili çevirisiTR Türk İşaret Dili çevirisi